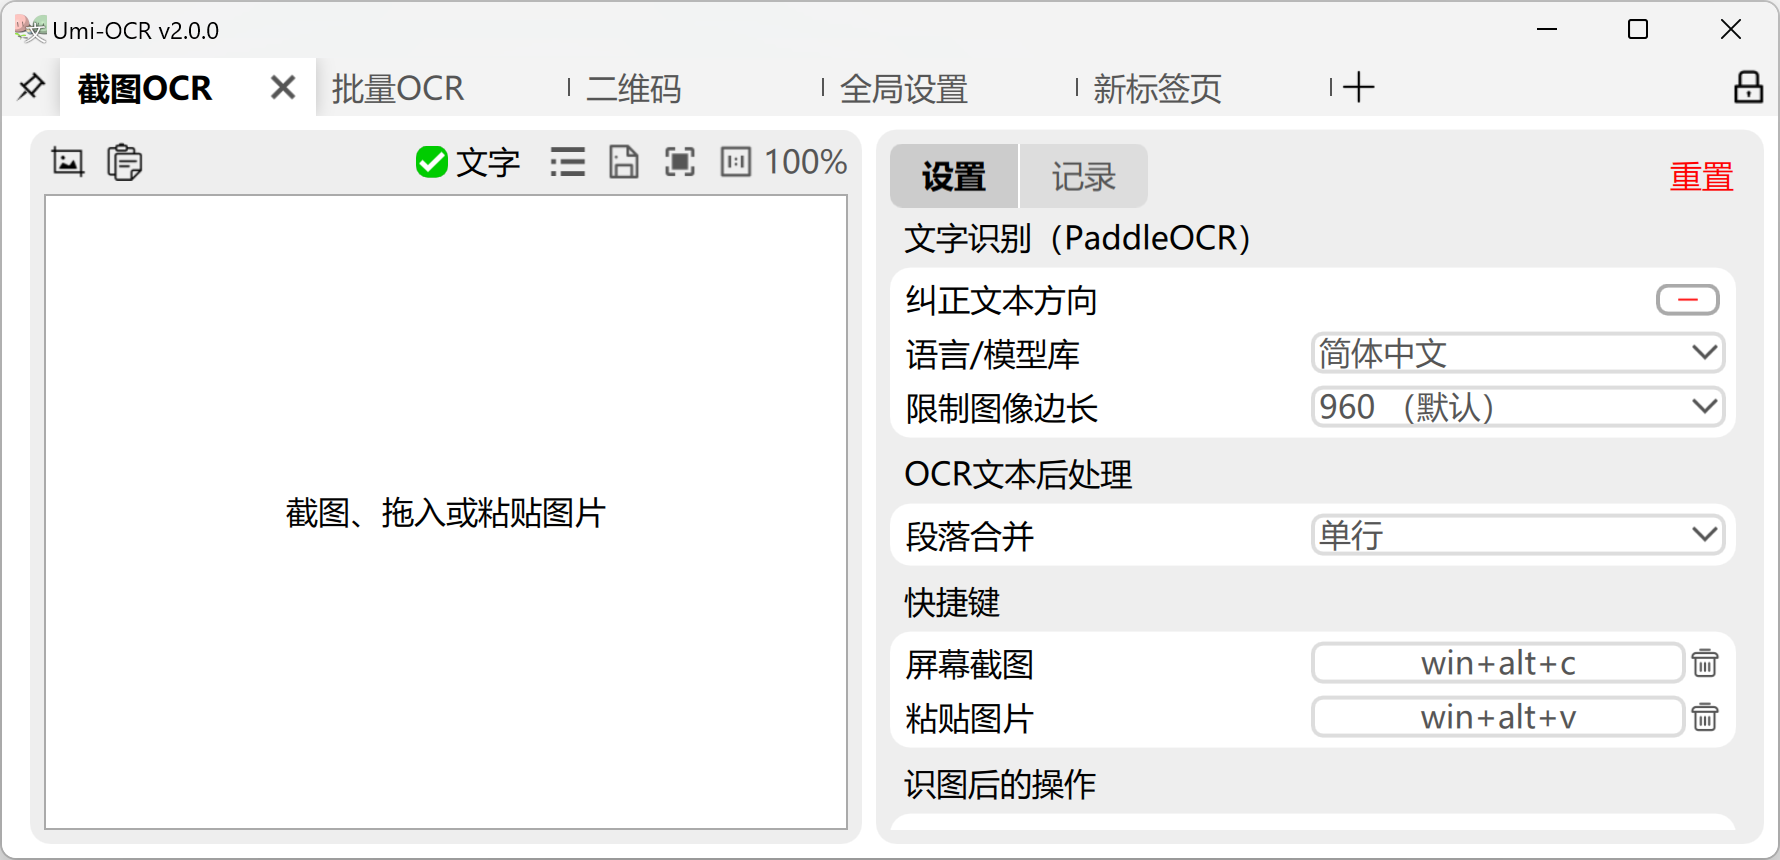
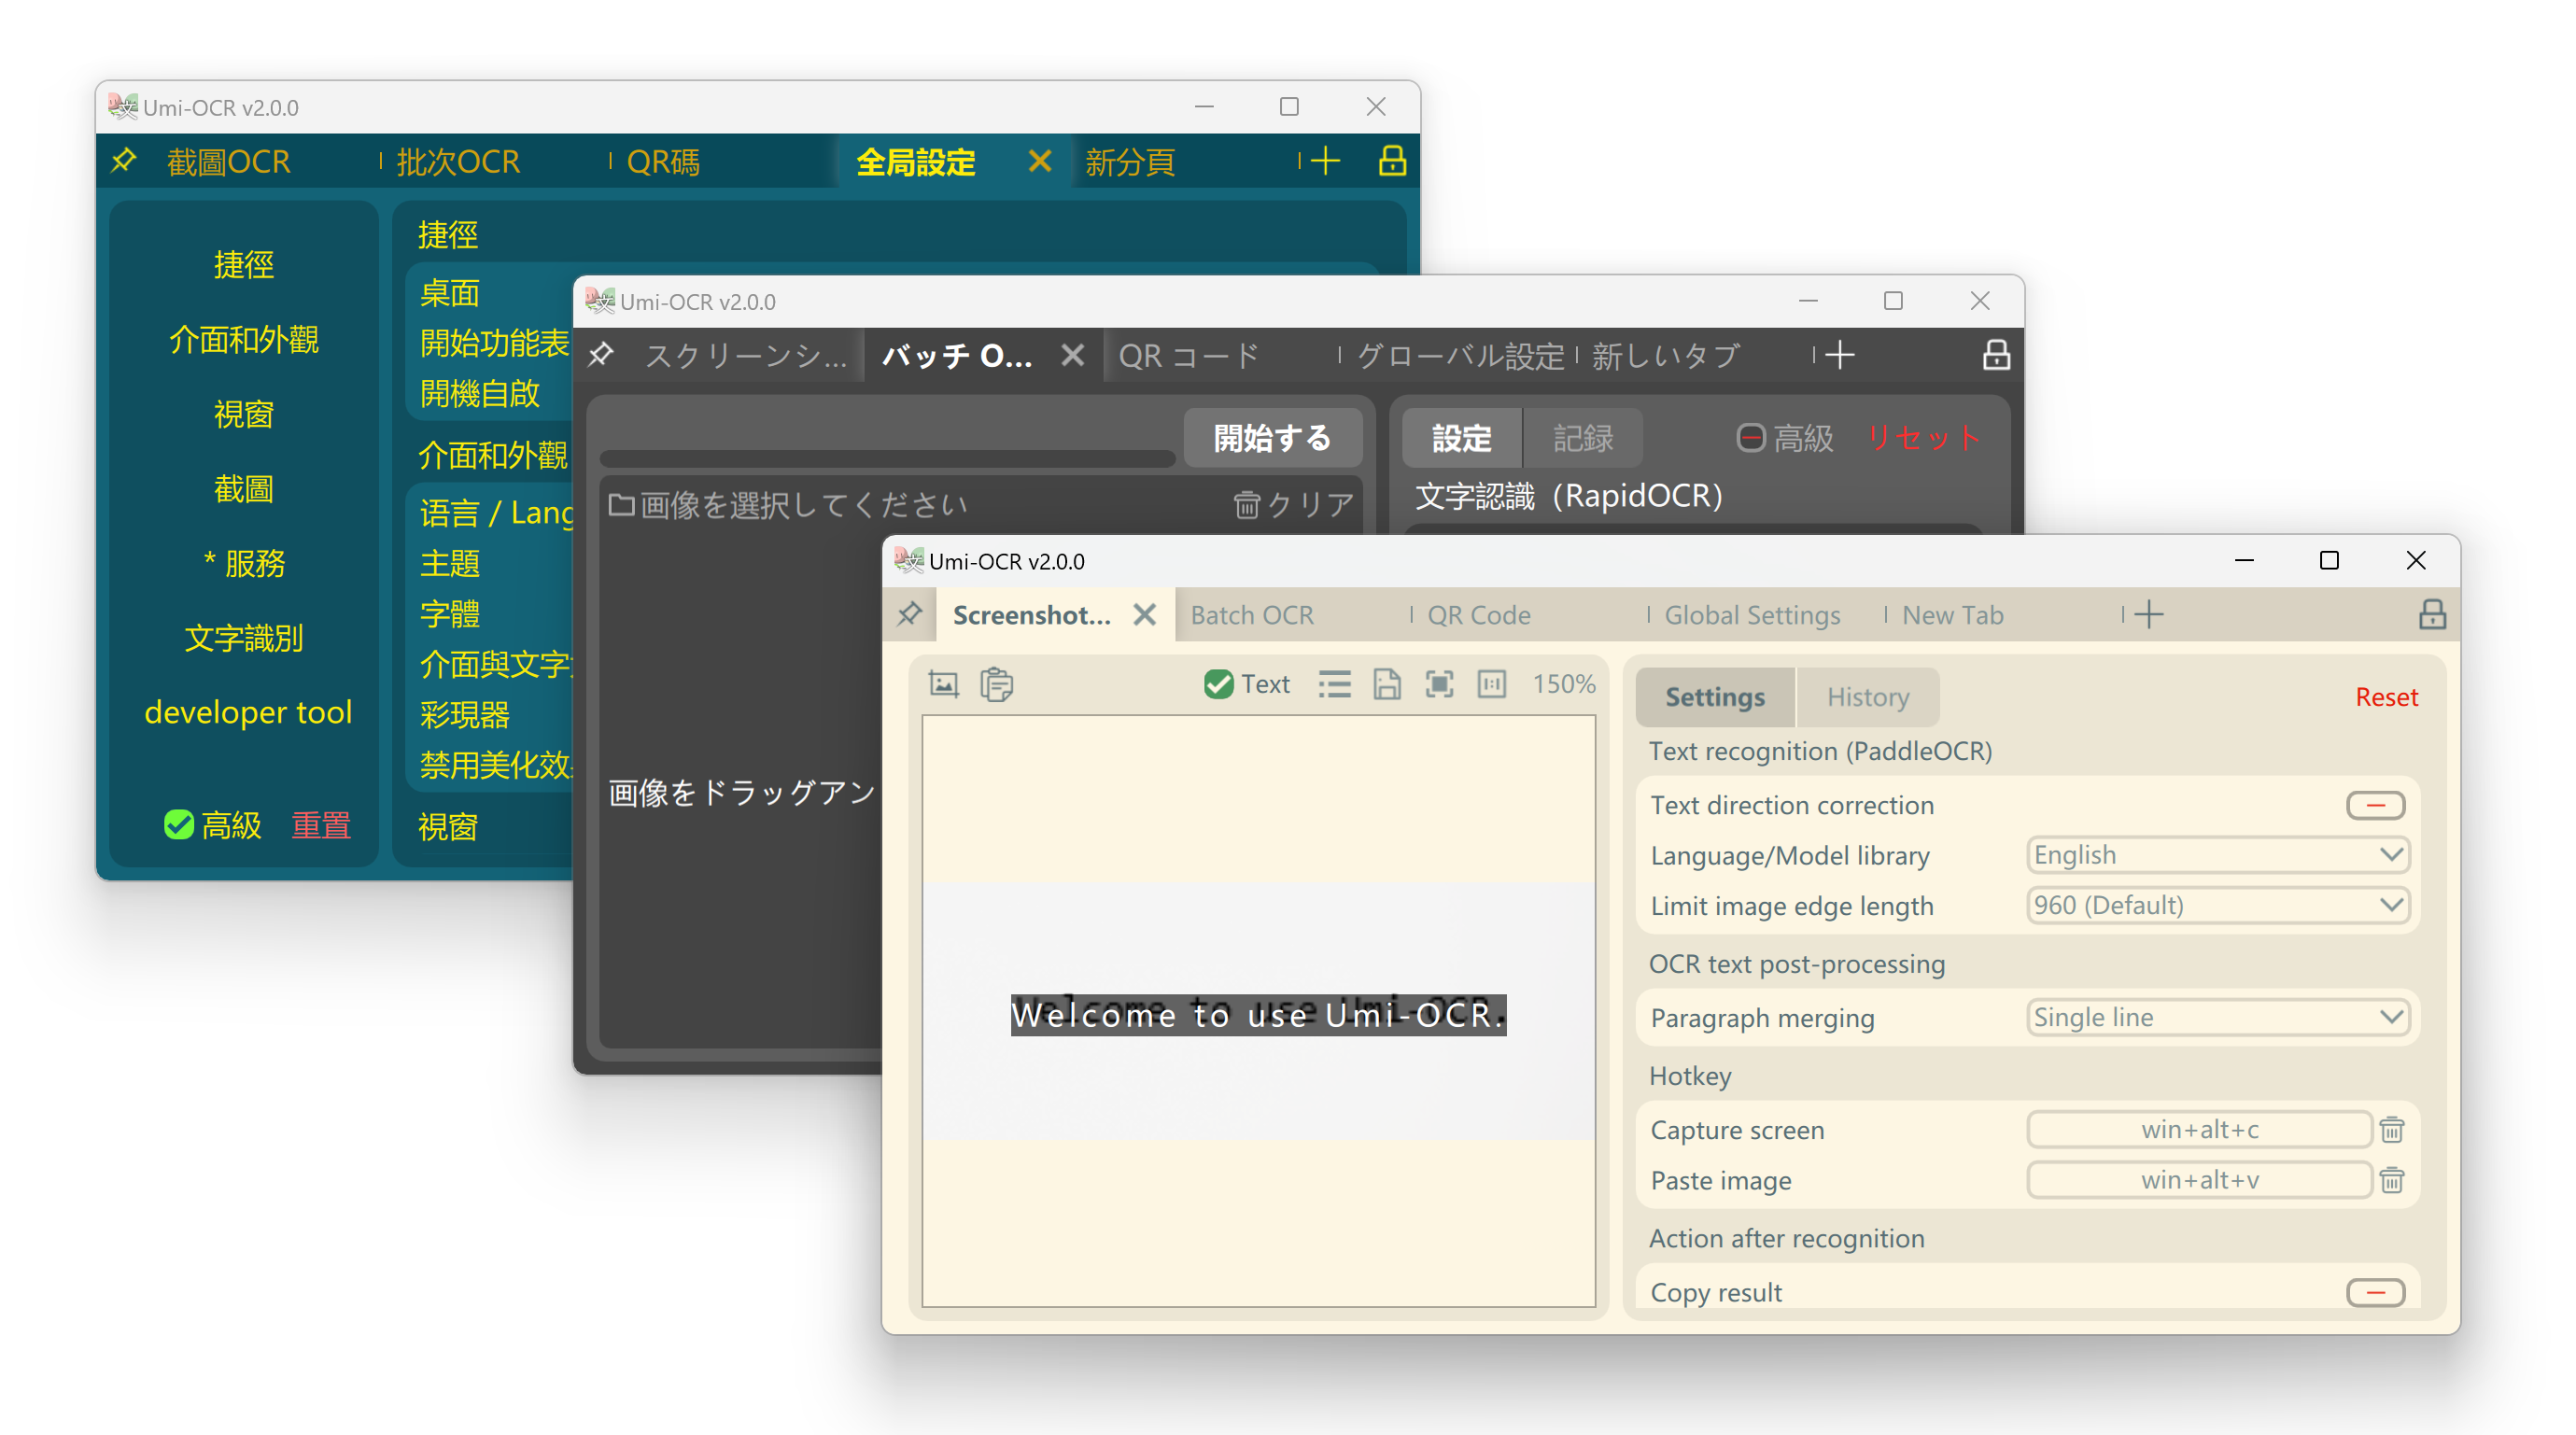
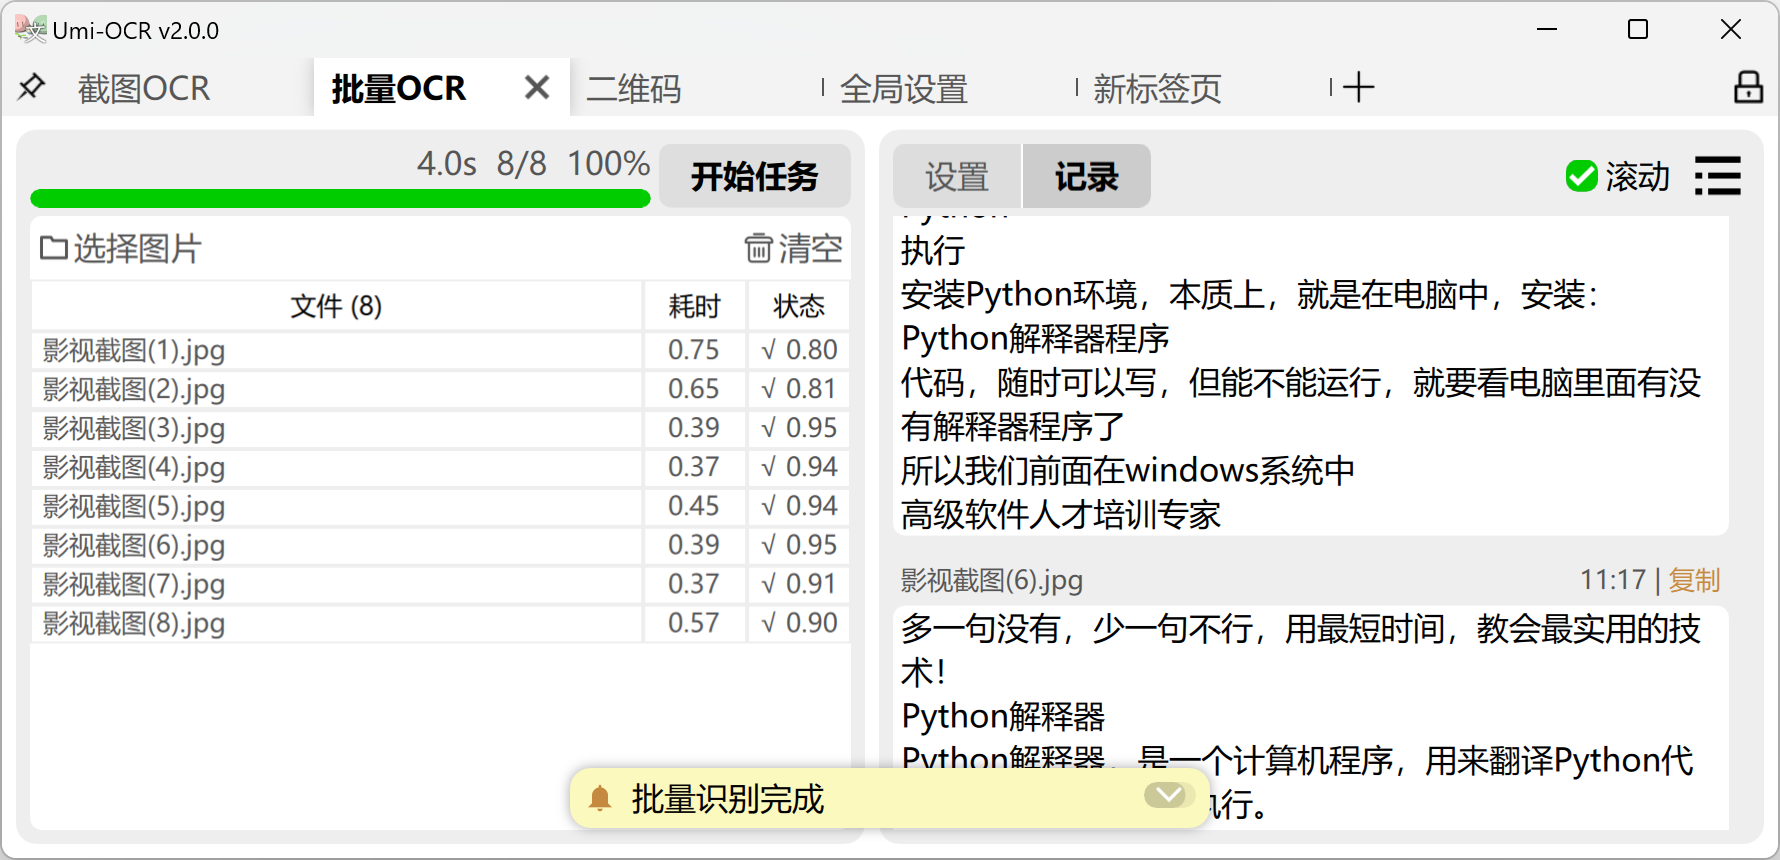
Umi-OCR 是一款免费、开源、完全离线的桌面 OCR 工具。基于 PaddleOCR 与 RapidOCR 引擎,支持截图识别、批量图片识别、PDF 转可搜索文档、二维码扫描/生成等。CPU 即可运行,不依赖显卡,对老旧机器友好。
它能做什么
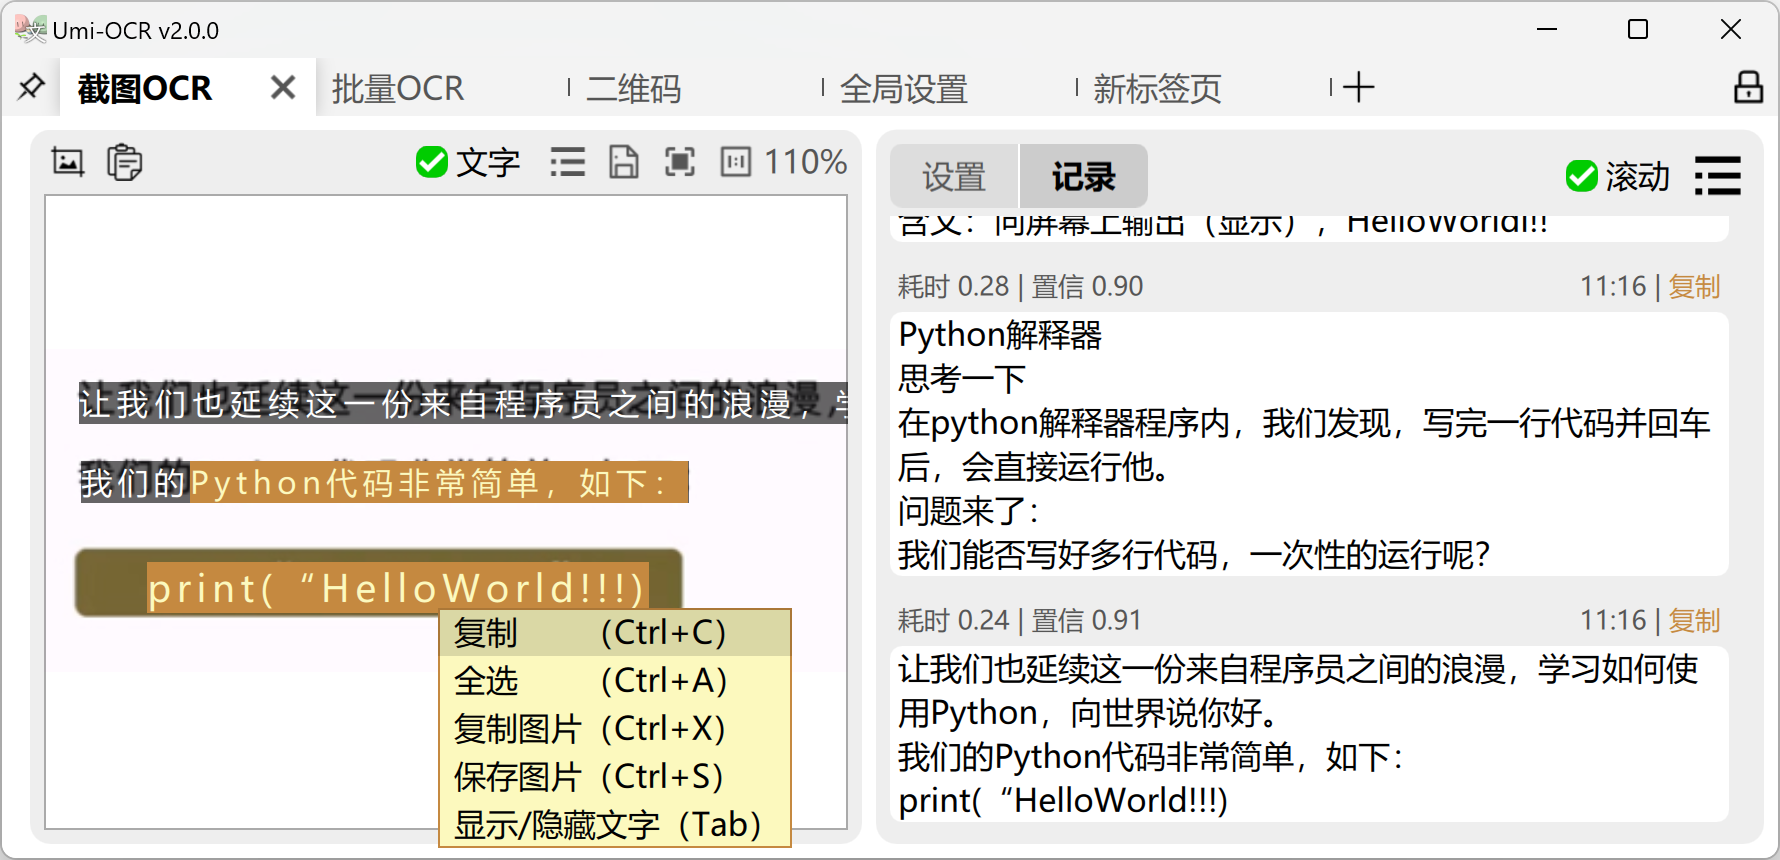
- 截图 OCR:快捷键框选屏幕任意区域,秒出可复制文字。
- 批量 OCR:拖入一批图片,自动排队识别,导出 txt / jsonl / md / csv。
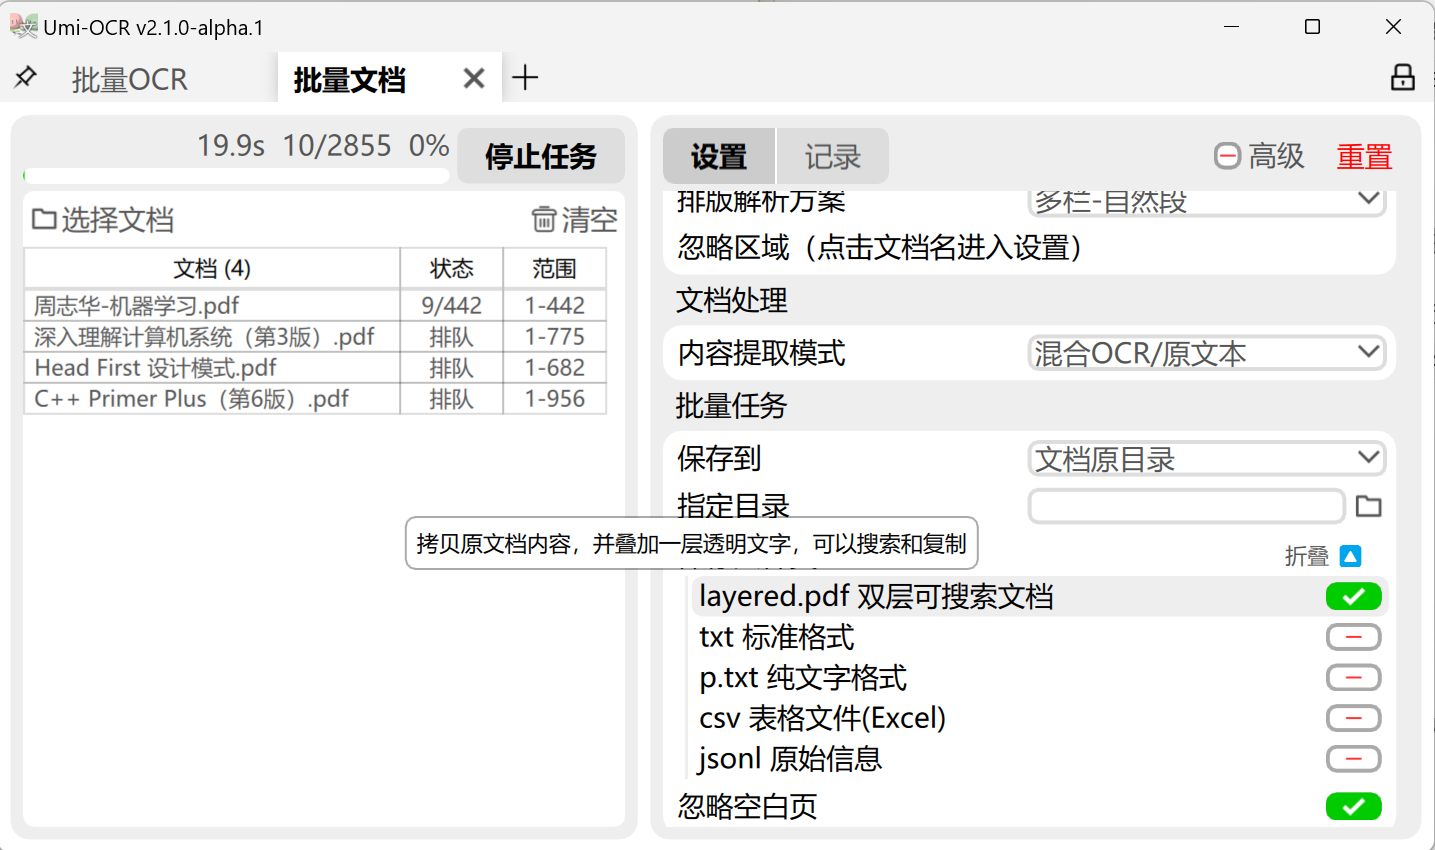
- 文档识别:PDF / XPS / EPUB / MOBI,输出双层可搜索 PDF(保留原图 + 可选中文字)。
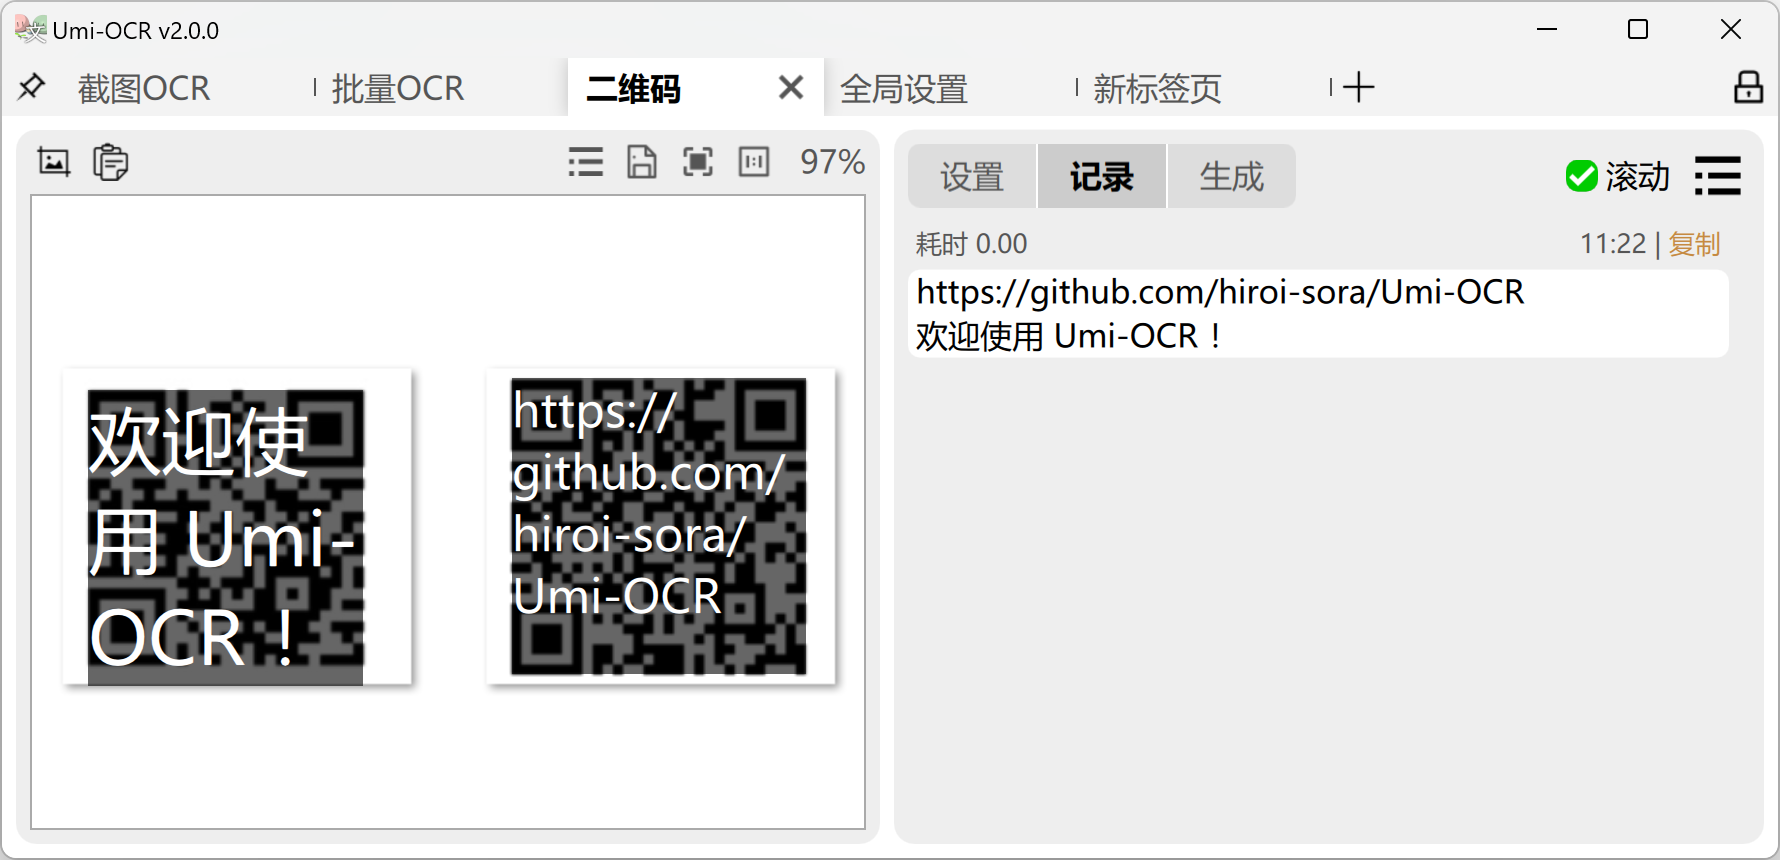
- 二维码:扫描屏幕中 19 种协议(含 QR / 条形码 / Aztec / DataMatrix 等),也能生成。
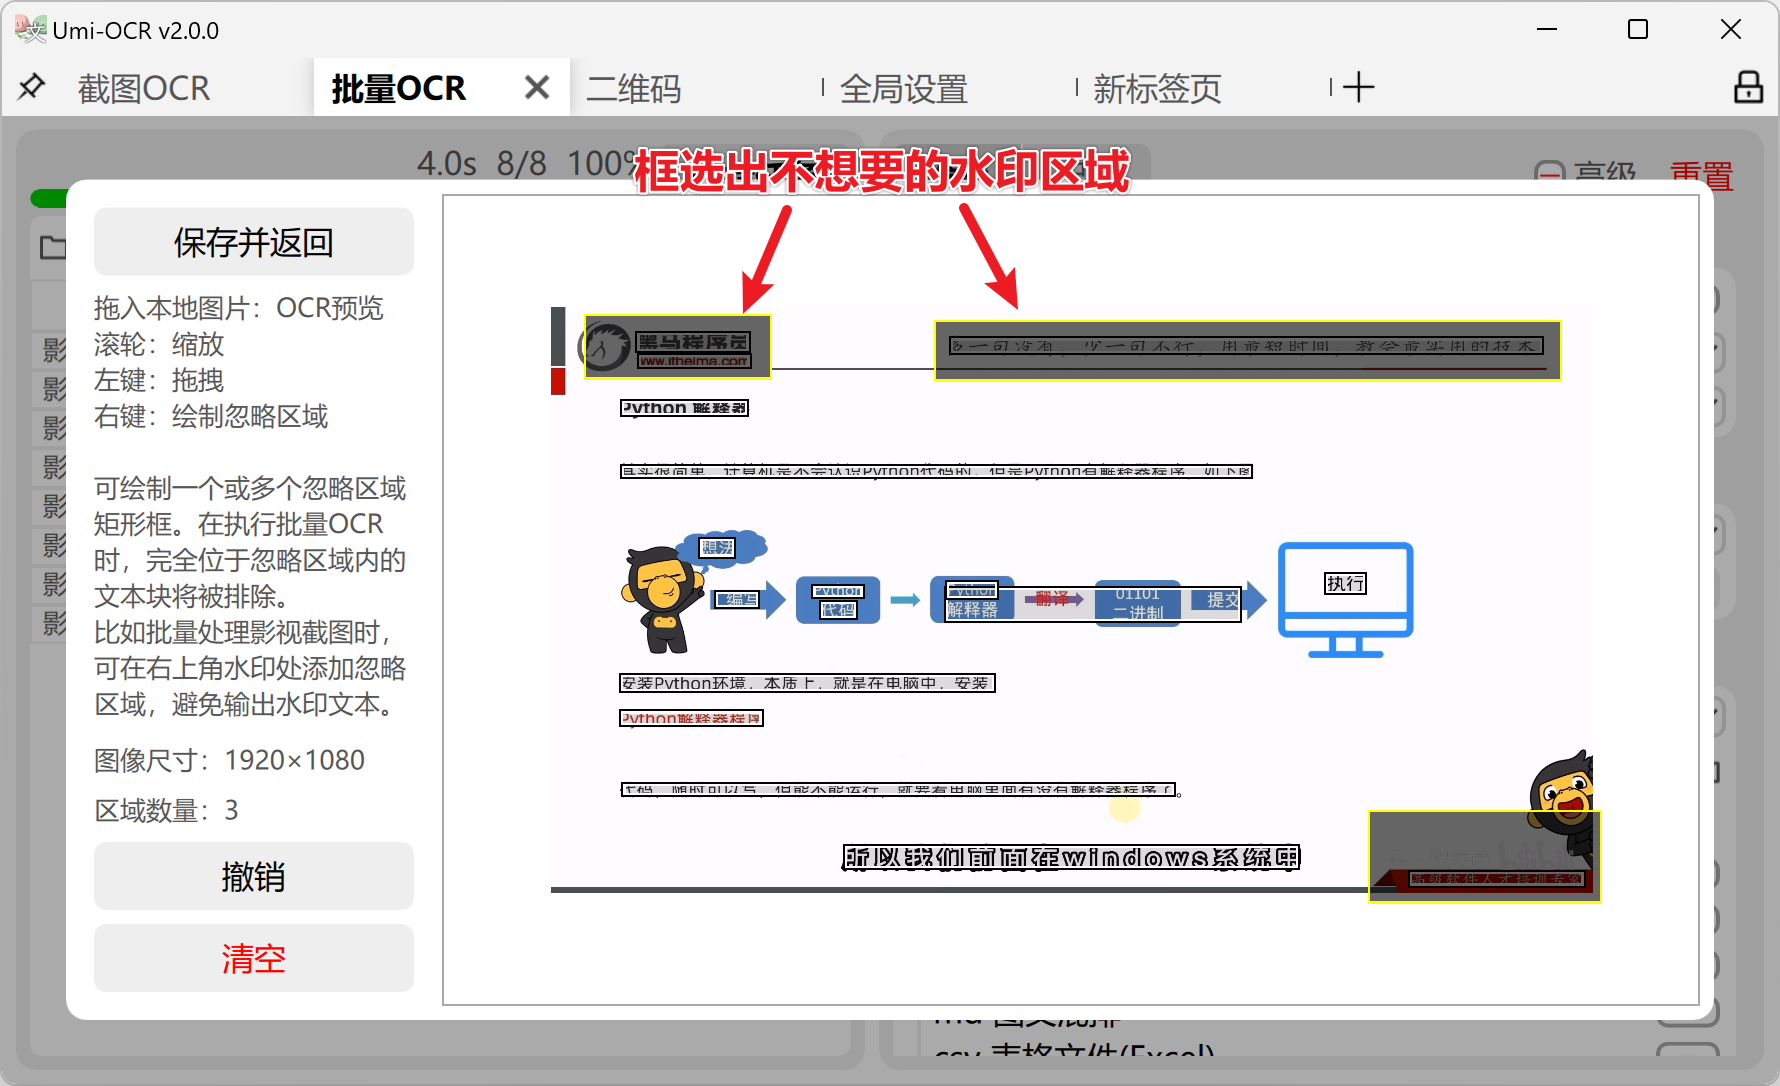
- 忽略区域:批量识别时框选水印 / LOGO / 页眉页脚,自动跳过。
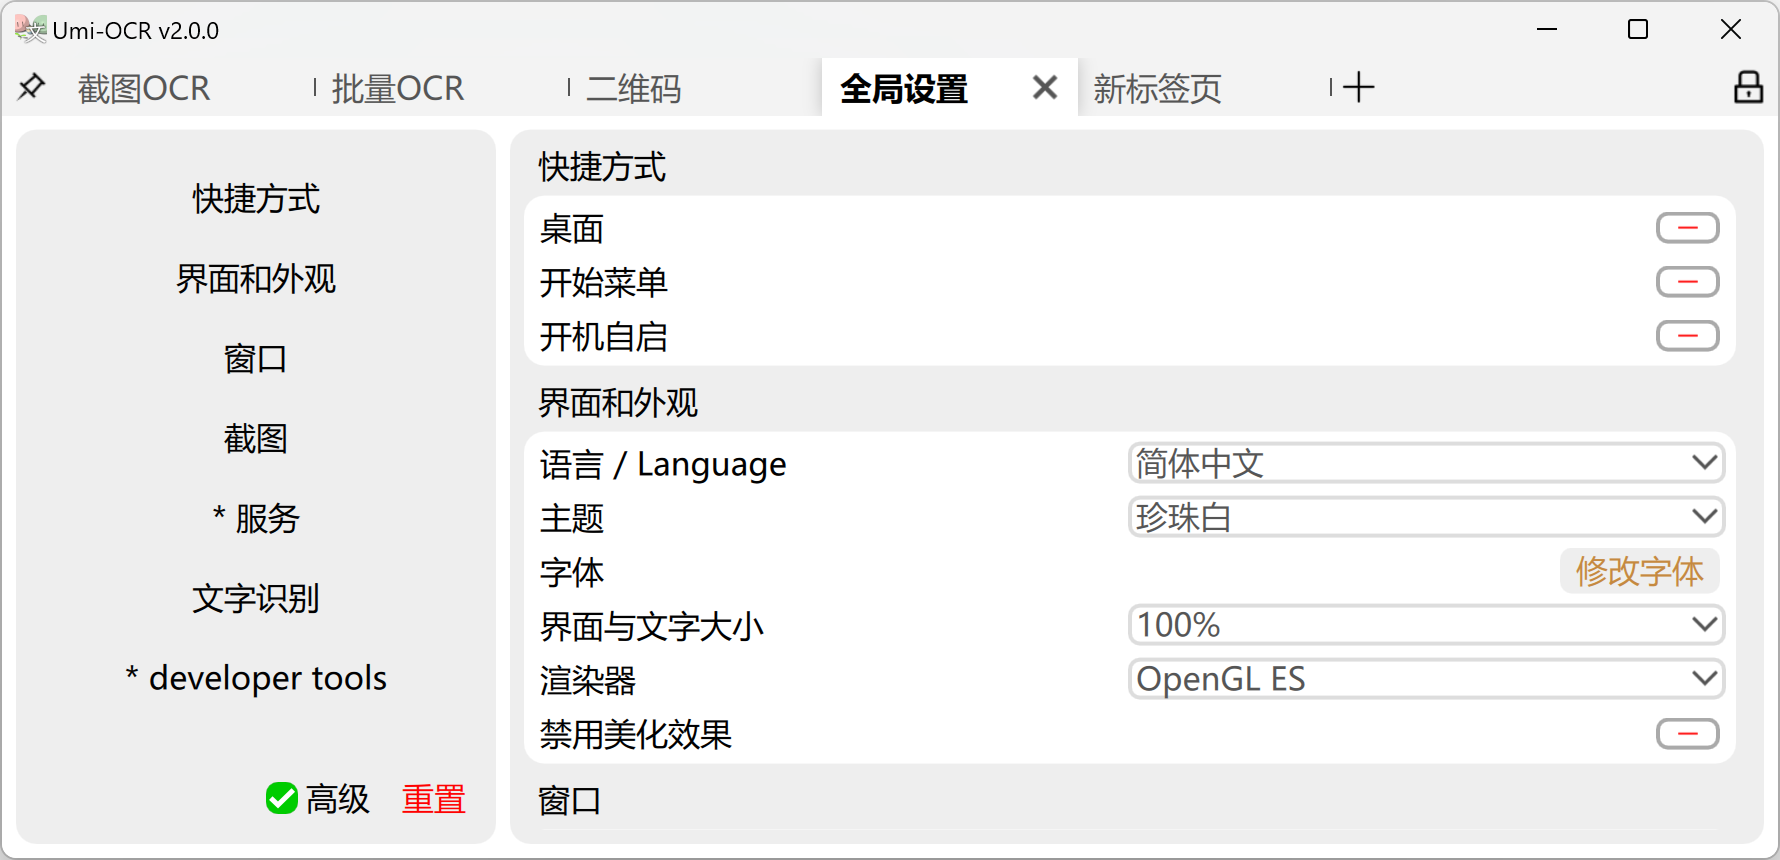
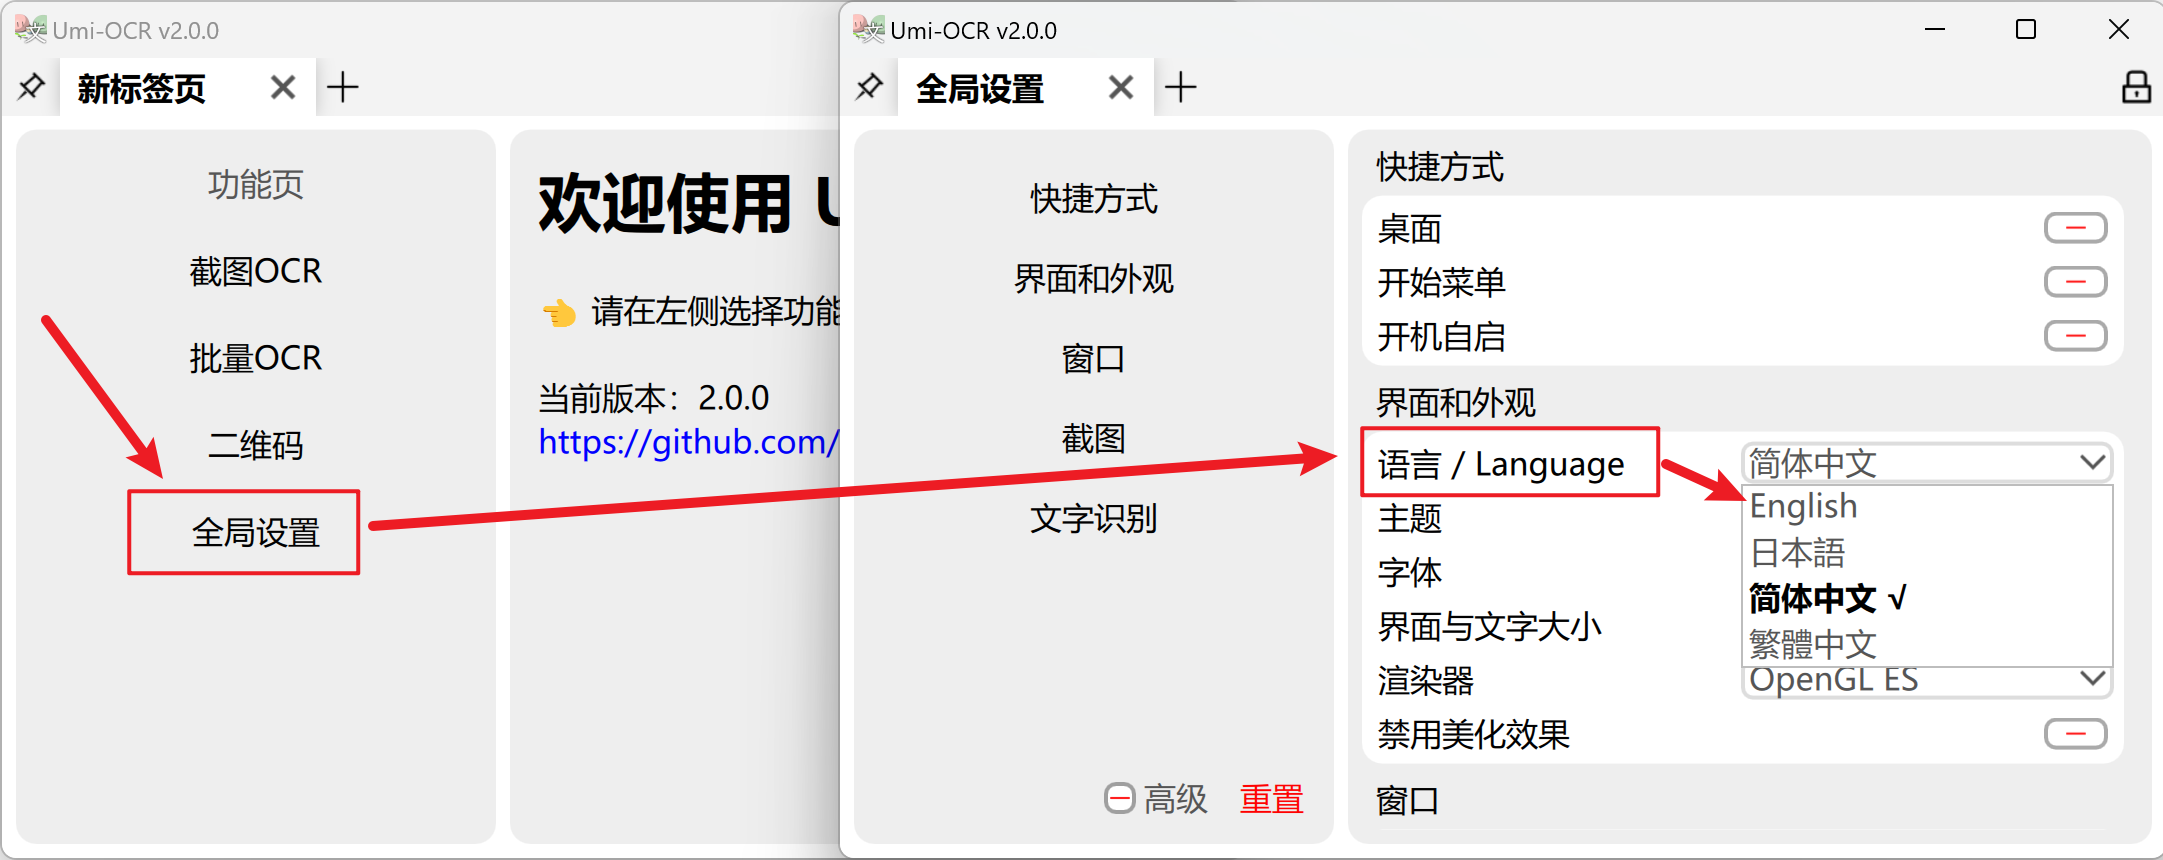
- 多语言界面:中、英、日、繁中等十几种语言,首次启动按系统语言自动切换。
- 命令行与 HTTP 接口:可写脚本、被其他软件嵌入调用。
它不能做什么
- 不做表格识别(导出 Excel):v2.1 之前一直标"远期计划",暂未实现。
- 不做公式识别:复杂数学公式认不出(issue #254 长期未完工)。
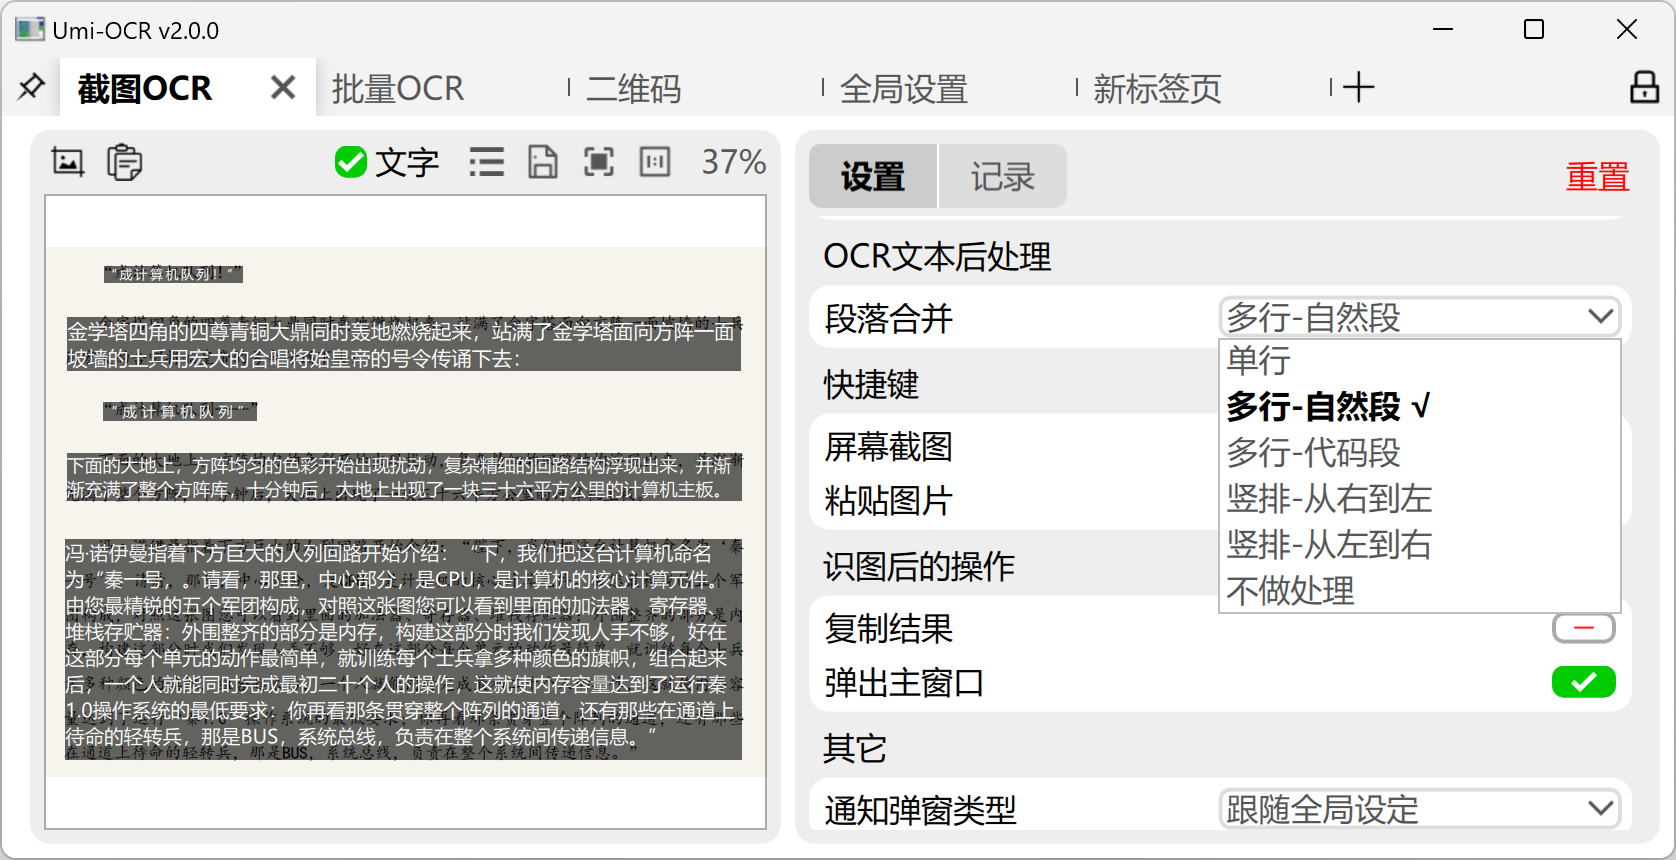
- 不做版式还原:多栏 / 竖排能识别出文字,版面顺序可能需后处理。
- 不支持 macOS:仅 Windows x64 与 Linux x64(Debian / Ubuntu 测试通过)。
开始前需要知道
- 完全免费、开源(MIT 协议),GitHub 46k+ Star,无广告无内购。
- 完全离线:首次启动自动下载约 100MB 识别模型,之后不联网;图片不传任何服务器。
- CPU 即可,不需要显卡——对老电脑 / 低配本子友好。
- 原生简体中文,从 Windows 7 x64 一直支持到 Windows 11。
- 两种引擎:Paddle(快、占内存,不兼容奔腾/赛扬/凌动)与 Rapid(稍慢、内存低、兼容性好)。低配机器选 Rapid。
- 最新稳定版 v2.1.5(三周年),本文截图来自官方 README 真实界面(v2.0.0 前后),v2.1.x 整体界面一致。
首次使用建议
- 去 GitHub Releases 选对应系统的安装包:Windows 选 Paddle 或 Rapid,Linux 选 tar.xz。
- 双击 .7z.exe 自解压,进入文件夹双击 Umi-OCR.exe 启动——免安装、不写注册表。
- 首次启动会自动下载约 100MB 识别模型,请保持联网,之后即可完全离线。
- 按默认 Win+Alt+C 截图 OCR;切到"批量 OCR"标签处理多图;切到"批量文档"处理 PDF。